На конференції Cloud 2026, що проходить у Китаї, компанія Alibaba представила нові досягнення у сфері великих мовних моделей та мультимодальних рішень. Зокрема, йдеться про впровадження рекурсивного самовдосконалення (RSI) у процеси навчання, виведення та співпраці з чипами. Про це повідомили у ITHome.
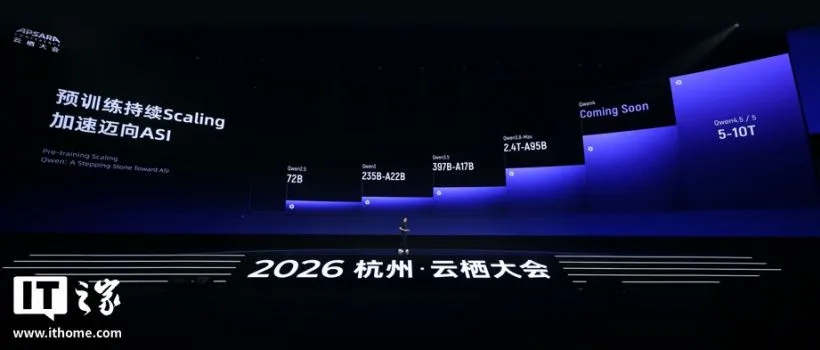
Компанія оголосила, що нова модель Qwen4 на базі архітектури наступного покоління вже проходить тренування. Наступні версії, зокрема Qwen4.5 та Qwen5, планують масштабувати до 5–10 трильйонів параметрів.
Окрім розвитку великих мовних моделей, Alibaba представила оновлені версії своїх рішень для генерації відео, аудіо, зображень, world models, музики та мультимодальних моделей. Особливий акцент зроблено на новій моделі генерації відео, реліз якої запланований на листопад. Вона має створювати довші, більш контрольовані та цілісні відео, забезпечуючи стабільність зображення, точний контроль персонажів, сцен і камер, а також «режисерське мислення» з переходом від окремих сцен до цілісної оповіді.
Alibaba також продемонструвала результати самостійного вдосконалення моделі Qwen3.8-Max із використанням RSI. Модель протягом понад місяця безперервного навчання здійснила 33 ітерації, самостійно будувала навчальні процеси, створювала дані, проєктувала експерименти та виявляла недоліки. Після цього, разом з оптимізацією після навчання, її показник на бенчмарку Artificial Analysis зріс з 40 до 45 пунктів, що ставить Qwen3.8-Max на рівень провідних моделей від Claude та GPT і вище за вітчизняні GLM5.3 та Kimi-K3.
Оптимізація виведення моделі включала автоматичну адаптацію Qwen3.8-Max до нової архітектури GPU від PingCap, де вона оптимізувала фреймворк виведення для Qwen3.8-Flash. Це дало змогу підвищити пропускну здатність виведення на 96% на одній інстанції.
У сфері взаємодії чипів і моделей Qwen3.8-Max, маючи лише специфікацію шинного модуля, самостійно пройшла повний цикл розробки — від передньої частини до верифікації та задньої частини. За 60 годин автономної роботи та понад 10 тисяч викликів інструментів EDA модель досягла оптимізації фізичної реалізації, зменшивши площу на 42%.
Віце-президент Alibaba з технологій ATH і головний науковий співробітник Taobao Tmall Group Чжен Бо висловив очікування, що протягом трьох років з’явиться універсальна мультимодальна модель, здатна подолати обмеження між різними типами контенту.
Компанія також прискорює впровадження своїх великих моделей на мобільні пристрої. Представлено рішення Qwen Intelligence для AI-смартфонів, яке глибоко оптимізовано під мобільні сценарії та надає партнерам платформу на базі агентських технологій. Це має дозволити смартфонам більш надійно виконувати складні завдання між різними застосунками.
Джерело: Expert
